不变子空间 #
这讲讲什么 :给「被算子映回自己内部的那块子空间」一个名字,然后证明它和特征值、特征向量、上三角矩阵其实是同一件事的三种说法。前置 :03 讲(子空间)、07 讲(线性映射)、08 讲(零空间与值域)、09 讲(矩阵);10 讲里「有限维空间上单射 ⟺ 满射 ⟺ 可逆」这一条会反复用到一句话 :不变子空间是「T T T
一、为什么需要它 #
1.1 一个具体的技术麻烦 #
设 T ∈ L ( V ) T\in\mathcal{L}(V) T ∈ L ( V ) V V V V V V
V = V 1 ⊕ V 2 ⊕ ⋯ ⊕ V m , V=V_1\oplus V_2\oplus\cdots\oplus V_m, V = V 1 ⊕ V 2 ⊕ ⋯ ⊕ V m ,
那么「理解 T T T T T T V k V_k V k V V V
麻烦在于:T ∣ V k T|_{V_k} T ∣ V k V k V_k V k 未必 把 V k V_k V k V k V_k V k V k V_k V k V V V
具体反例。 取 V = R 2 V=\mathbb{R}^2 V = R 2 T ( w , z ) = ( z , w ) T(w,z)=(z,w) T ( w , z ) = ( z , w ) U = { ( x , 0 ) : x ∈ R } U=\{(x,0):x\in\mathbb{R}\} U = {( x , 0 ) : x ∈ R } x x x
T ( 1 , 0 ) = ( 0 , 1 ) ∉ U . T(1,0)=(0,1)\notin U . T ( 1 , 0 ) = ( 0 , 1 ) ∈ / U .
所以 T ∣ U T|_U T ∣ U U U U U U U V V V
这不是小毛病。算子比一般线性映射内容丰富,主要就靠能自乘 (T 2 = T ∘ T T^2=T\circ T T 2 = T ∘ T T m T^m T m p ( T ) p(T) p ( T ) T ∣ V k T|_{V_k} T ∣ V k
于是把问题剪干净:只研究那些 T T T 给它起个名字,就是本讲的主角。
1.2 第二个动机:简单矩阵从哪来 #
09 讲里算子的矩阵 M ( T ) M(T) M ( T ) 0 0 0
一个方阵能有多简单?最理想是对角阵。次一等是上三角 :对角线以下的元素全是 0 0 0 M ( T ) M(T) M ( T )
span ( v 1 ) ⊂ span ( v 1 , v 2 ) ⊂ ⋯ ⊂ span ( v 1 , … , v n ) = V \operatorname{span}(v_1)\subset\operatorname{span}(v_1,v_2)\subset\cdots\subset\operatorname{span}(v_1,\dots,v_n)=V span ( v 1 ) ⊂ span ( v 1 , v 2 ) ⊂ ⋯ ⊂ span ( v 1 , … , v n ) = V
这样一条层层加高的不变子空间链 。也就是说:想让矩阵变简单,就得先会找不变子空间。
1.3 读完这一讲你应该能回答 #
给定 T T T U U U U U U T T T
「T T T T T T
一个 n n n
二、定义与最小例子 #
2.1 定义 #
定义(不变子空间) :设 T ∈ L ( V ) T\in\mathcal{L}(V) T ∈ L ( V ) V V V U U U T T T 不变 ,若对每个 u ∈ U u\in U u ∈ U
T u ∈ U . Tu\in U . T u ∈ U .
等价记号:T ( U ) ⊆ U T(U)\subseteq U T ( U ) ⊆ U
读这个定义有三个地方要咬住:
(i)U U U 任意子集谈不上「不变」,因为定义里要写 T u ∈ U Tu\in U T u ∈ U 每个 u u u U U U dim U \dim U dim U T ∣ U T|_U T ∣ U
(ii)关系是 ⊆ \subseteq ⊆ = = = 值域 T ( U ) T(U) T ( U ) U U U 小 。这一点后面会变成最常见的一类错误(见第五节误区 2)。
(iii)T T T V V V ,即定义空间就是 V V V V V V V V V W W W W ≠ V W\neq V W = V T U TU T U W W W U U U V V V
2.2 四个白送的例子 #
对任意 T ∈ L ( V ) T\in\mathcal{L}(V) T ∈ L ( V ) 自己把理由说一遍 ,这是最快的上手方式:
子空间
为什么不变
{ 0 } \{0\} { 0 } 若 u ∈ { 0 } u\in\{0\} u ∈ { 0 } u = 0 u=0 u = 0 T u = T 0 = 0 ∈ { 0 } Tu=T0=0\in\{0\} T u = T 0 = 0 ∈ { 0 }
V V V 若 u ∈ V u\in V u ∈ V T u ∈ V Tu\in V T u ∈ V V V V
null T \operatorname{null}T null T 若 u ∈ null T u\in\operatorname{null}T u ∈ null T T u = 0 Tu=0 T u = 0 0 ∈ null T 0\in\operatorname{null}T 0 ∈ null T
range T \operatorname{range}T range T 若 u ∈ range T u\in\operatorname{range}T u ∈ range T u = T v u=Tv u = T v v v v T u = T ( T v ) = T 2 v ∈ range T Tu=T(Tv)=T^2v\in\operatorname{range}T T u = T ( T v ) = T 2 v ∈ range T
它们白送 ,但常常退化 。T T T null T = { 0 } \operatorname{null}T=\{0\} null T = { 0 } range T = V \operatorname{range}T=V range T = V null T \operatorname{null}T null T range T \operatorname{range}T range T { 0 } \{0\} { 0 } V V V 中间那些维数的子空间,能不能也不变?
2.3 一个非 F n \mathbb{F}^n F n #
取 V = P ( R ) V=\mathcal{P}(\mathbb{R}) V = P ( R ) T = D T=D T = D D p = p ′ Dp=p' D p = p ′
那么 U = P 4 ( R ) U=\mathcal{P}_4(\mathbb{R}) U = P 4 ( R ) 4 4 4 D D D p p p ≤ 4 \le 4 ≤ 4 p ′ ∈ P 4 ( R ) p'\in\mathcal{P}_4(\mathbb{R}) p ′ ∈ P 4 ( R )
更进一步,整条链都不变:
P 0 ⊂ P 1 ⊂ P 2 ⊂ ⋯ ⊂ P 4 . \mathcal{P}_0\subset\mathcal{P}_1\subset\mathcal{P}_2\subset\cdots\subset\mathcal{P}_4 . P 0 ⊂ P 1 ⊂ P 2 ⊂ ⋯ ⊂ P 4 .
而 P 5 \mathcal{P}_5 P 5 D D D 仍然不变 (次数照样只降)。想找一个「求导会跑出来」的例子,得反过来:取 U = span ( 1 + x 3 ) U=\operatorname{span}(1+x^3) U = span ( 1 + x 3 ) D ( 1 + x 3 ) = 3 x 2 ∉ U D(1+x^3)=3x^2\notin U D ( 1 + x 3 ) = 3 x 2 ∈ / U
一维子空间 span ( v ) \operatorname{span}(v) span ( v ) T T T T v ∈ span ( v ) Tv\in\operatorname{span}(v) T v ∈ span ( v ) T v Tv T v v v v
2.4 一个不变、一个不变的反例 #
同一个 T T T
取 V = R 2 V=\mathbb{R}^2 V = R 2 T ( w , z ) = ( z , w ) T(w,z)=(z,w) T ( w , z ) = ( z , w )
U 1 = { ( x , x ) : x ∈ R } U_1=\{(x,x):x\in\mathbb{R}\} U 1 = {( x , x ) : x ∈ R } y = x y=x y = x T ( x , x ) = ( x , x ) ∈ U 1 T(x,x)=(x,x)\in U_1 T ( x , x ) = ( x , x ) ∈ U 1 不变 ,而且每个向量都被原地不动 。U 2 = { ( x , − x ) : x ∈ R } U_2=\{(x,-x):x\in\mathbb{R}\} U 2 = {( x , − x ) : x ∈ R } y = − x y=-x y = − x T ( x , − x ) = ( − x , x ) = − ( x , − x ) ∈ U 2 T(x,-x)=(-x,x)=-(x,-x)\in U_2 T ( x , − x ) = ( − x , x ) = − ( x , − x ) ∈ U 2 不变 ,但每个向量都被翻了个方向 (乘 − 1 -1 − 1 U 3 = { ( x , 0 ) } U_3=\{(x,0)\} U 3 = {( x , 0 )} x x x T ( x , 0 ) = ( 0 , x ) T(x,0)=(0,x) T ( x , 0 ) = ( 0 , x ) x = 0 x=0 x = 0 不变性失败 。
三条直线都过原点、都是一维子空间,命运完全不同。区分它们的不是「长得像不像」,而是T T T
三、几个必须自己算一遍的结论 #
3.1 一维不变子空间 ⟺ 特征向量 #
设 v ≠ 0 v\neq 0 v = 0 U = span ( v ) = { λ v : λ ∈ F } U=\operatorname{span}(v)=\{\lambda v:\lambda\in\mathbb{F}\} U = span ( v ) = { λ v : λ ∈ F } V V V V V V
若 U U U T T T T v ∈ U Tv\in U T v ∈ U λ ∈ F \lambda\in\mathbb{F} λ ∈ F
T v = λ v . Tv=\lambda v . T v = λ v .
反之,若对某个 λ ∈ F \lambda\in\mathbb{F} λ ∈ F T v = λ v Tv=\lambda v T v = λ v μ \mu μ
T ( μ v ) = μ T v = μ λ v = ( μ λ ) v ∈ span ( v ) , T(\mu v)=\mu\,Tv=\mu\lambda v=(\mu\lambda)v\in\operatorname{span}(v), T ( μv ) = μ T v = μ λ v = ( μ λ ) v ∈ span ( v ) ,
所以 span ( v ) \operatorname{span}(v) span ( v )
于是得到这一讲的核心等价:
V V V T T T ⟺ \iff ⟺ T T T
一句话都不多:找一维不变子空间 = 解 T v = λ v Tv=\lambda v T v = λ v
3.2 特征值与特征向量 #
定义(特征值) :设 T ∈ L ( V ) T\in\mathcal{L}(V) T ∈ L ( V ) λ ∈ F \lambda\in\mathbb{F} λ ∈ F T T T 特征值 ,若存在 v ∈ V v\in V v ∈ V v ≠ 0 v\neq 0 v = 0 T v = λ v Tv=\lambda v T v = λ v
定义(特征向量) :设 T ∈ L ( V ) T\in\mathcal{L}(V) T ∈ L ( V ) λ \lambda λ T T T v ≠ 0 v\neq 0 v = 0 T v = λ v Tv=\lambda v T v = λ v v v v T T T 对应于 λ \lambda λ 特征向量。
为什么非要 v ≠ 0 v\neq 0 v = 0 因为 T 0 = λ 0 T0=\lambda 0 T 0 = λ 0 每个 标量 λ \lambda λ
特征向量的另一种描述 :v ≠ 0 v\neq 0 v = 0 T T T λ \lambda λ
( T − λ I ) v = 0 , 即 v ∈ null ( T − λ I ) , v ≠ 0. (T-\lambda I)v=0,\qquad\text{即}\qquad v\in\operatorname{null}(T-\lambda I),\ v\neq 0 . ( T − λ I ) v = 0 , 即 v ∈ null ( T − λ I ) , v = 0.
也就是说:对应 λ \lambda λ 0 0 0 null ( T − λ I ) \operatorname{null}(T-\lambda I) null ( T − λ I ) 。所以「特征向量」不是散的,它们天然成块。
"eigen" 是德文前缀,意为「自身的」。特征值刻画的是算子自己固有 的伸缩倍数,不随你选哪个基而改变。
3.3 当特征值的四个等价条件 #
下面这一条只在有限维 成立,而且它把「解方程」翻译成「判断可逆性」:
定理 :设 V V V T ∈ L ( V ) T\in\mathcal{L}(V) T ∈ L ( V ) λ ∈ F \lambda\in\mathbb{F} λ ∈ F
(a) λ \lambda λ T T T T − λ I T-\lambda I T − λ I T − λ I T-\lambda I T − λ I T − λ I T-\lambda I T − λ I
证明的骨架。 (a) ⟺ \iff ⟺ T v = λ v Tv=\lambda v T v = λ v ( T − λ I ) v = 0 (T-\lambda I)v=0 ( T − λ I ) v = 0 v ≠ 0 v\neq 0 v = 0 0 0 0 T − λ I T-\lambda I T − λ I
(b)、(c)、(d) 三者等价,用的正是 10 讲那条:有限维空间上,单射 ⟺ 满射 ⟺ 可逆。 注意这里的「有限维」不能去掉——无穷维时单射不必满射(例如多项式上的移位算子)。
它把「求特征值」从解一个含未知向量的方程 ,变成了判断一个算子是否可逆 。T − λ I T-\lambda I T − λ I λ \lambda λ det ( T − λ I ) = 0 \det(T-\lambda I)=0 det ( T − λ I ) = 0 特征值 = 让 T − λ I T-\lambda I T − λ I λ \lambda λ
3.4 例一:先动手验一个 #
定义 T ∈ L ( F 3 ) T\in\mathcal{L}(\mathbb{F}^3) T ∈ L ( F 3 )
T ( x , y , z ) = ( 7 x + 3 z , 3 x + 6 y + 9 z , − 6 y ) . T(x,y,z)=(7x+3z,\ 3x+6y+9z,\ -6y). T ( x , y , z ) = ( 7 x + 3 z , 3 x + 6 y + 9 z , − 6 y ) .
直接代 v = ( 3 , 1 , − 1 ) v=(3,1,-1) v = ( 3 , 1 , − 1 )
T ( 3 , 1 , − 1 ) = ( 21 − 3 , 9 + 6 − 9 , − 6 ) = ( 18 , 6 , − 6 ) = 6 ( 3 , 1 , − 1 ) . \begin{aligned}T(3,1,-1)&=(21-3,\ 9+6-9,\ -6)\\&=(18,\ 6,\ -6)=6(3,1,-1).\end{aligned} T ( 3 , 1 , − 1 ) = ( 21 − 3 , 9 + 6 − 9 , − 6 ) = ( 18 , 6 , − 6 ) = 6 ( 3 , 1 , − 1 ) .
所以 6 6 6 T T T ( 3 , 1 , − 1 ) (3,1,-1) ( 3 , 1 , − 1 )
注意这题只验证了「6 6 6 6 6 6 要找出全部特征值,得解 T − λ I T-\lambda I T − λ I 给一个数、给一个向量,代入验证是最快的入门动作。
3.5 例二:同一个算子,换个数域就换个答案 #
设 T ∈ L ( F 2 ) T\in\mathcal{L}(\mathbb{F}^2) T ∈ L ( F 2 ) T ( w , z ) = ( − z , w ) T(w,z)=(-z,w) T ( w , z ) = ( − z , w ) 90 ∘ 90^\circ 9 0 ∘
当 F = R \mathbb{F}=\mathbb{R} F = R T T T
几何理由一句话:把非零向量转 90 ∘ 90^\circ 9 0 ∘ T − λ I T-\lambda I T − λ I
( − λ − 1 1 − λ ) , \begin{pmatrix}-\lambda&-1\\ 1&-\lambda\end{pmatrix}, ( − λ 1 − 1 − λ ) ,
要它不可逆就要求 λ 2 = − 1 \lambda^2=-1 λ 2 = − 1
当 F = C \mathbb{F}=\mathbb{C} F = C T T T i i i − i -i − i
解方程 − z = λ w -z=\lambda w − z = λ w w = λ z w=\lambda z w = λ z − z = λ 2 z -z=\lambda^2 z − z = λ 2 z z ≠ 0 z\neq 0 z = 0 w = 0 w=0 w = 0 z z z
λ 2 = − 1 ⟹ λ = ± i . \lambda^2=-1 \quad\Longrightarrow\quad \lambda=\pm i . λ 2 = − 1 ⟹ λ = ± i .
代入验证:T ( w , − w i ) = ( w i , w ) T(w,-wi)=(wi,\ w) T ( w , − w i ) = ( w i , w ) i ( w , − w i ) = ( i w , i ⋅ ( − w i ) ) = ( i w , w ) i(w,-wi)=(iw,\ i\cdot(-wi))=(iw,\ w) i ( w , − w i ) = ( i w , i ⋅ ( − w i )) = ( i w , w ) ( w , − w i ) (w,-wi) ( w , − w i ) w ≠ 0 w\neq 0 w = 0 i i i ( w , w i ) (w,wi) ( w , w i ) − i -i − i
特征值存不存在,取决于数域,不只取决于算子。 90 ∘ 90^\circ 9 0 ∘ R 2 \mathbb{R}^2 R 2 C 2 \mathbb{C}^2 C 2 T T T 不完整 ——必须问「在哪个数域上」。
3.6 不同特征值的特征向量线性无关 #
定理 :设 T ∈ L ( V ) T\in\mathcal{L}(V) T ∈ L ( V ) T T T 互不相同 特征值的特征向量,构成的每个组都线性无关。
这条比它看起来强。它说的是:只要特征值互不相同,向量自动无关 ,不需要额外检查。
证明(反证 + 取最小 m m m
假设结论不成立。那么存在最小的正整数 m m m λ 1 , … , λ m \lambda_1,\dots,\lambda_m λ 1 , … , λ m v 1 , … , v m v_1,\dots,v_m v 1 , … , v m
注意 m ≥ 2 m\ge 2 m ≥ 2
于是有不全为零的系数使
a 1 v 1 + ⋯ + a m v m = 0. (3.1) a_1v_1+\cdots+a_mv_m=0. \tag{3.1} a 1 v 1 + ⋯ + a m v m = 0. ( 3.1 )
第一步:这些系数全都不为零。 若某个 a j = 0 a_j=0 a j = 0 m − 1 m-1 m − 1 m m m a 1 , … , a m a_1,\dots,a_m a 1 , … , a m
第二步:用 T − λ m I T-\lambda_mI T − λ m I 关键观察是
( T − λ m I ) v k = T v k − λ m v k = λ k v k − λ m v k = ( λ k − λ m ) v k , (T-\lambda_mI)v_k=Tv_k-\lambda_mv_k=\lambda_kv_k-\lambda_mv_k=(\lambda_k-\lambda_m)v_k, ( T − λ m I ) v k = T v k − λ m v k = λ k v k − λ m v k = ( λ k − λ m ) v k ,
而 ( T − λ m I ) v m = 0 (T-\lambda_mI)v_m=0 ( T − λ m I ) v m = 0
a 1 ( λ 1 − λ m ) v 1 + ⋯ + a m − 1 ( λ m − 1 − λ m ) v m − 1 = 0. (3.2) a_1(\lambda_1-\lambda_m)v_1+\cdots+a_{m-1}(\lambda_{m-1}-\lambda_m)v_{m-1}=0. \tag{3.2} a 1 ( λ 1 − λ m ) v 1 + ⋯ + a m − 1 ( λ m − 1 − λ m ) v m − 1 = 0. ( 3.2 )
第三步:读出矛盾。 因为 λ 1 , … , λ m \lambda_1,\dots,\lambda_m λ 1 , … , λ m λ k − λ m ≠ 0 \lambda_k-\lambda_m\neq 0 λ k − λ m = 0 k < m k<m k < m a k ≠ 0 a_k\neq 0 a k = 0 a k ( λ k − λ m ) a_k(\lambda_k-\lambda_m) a k ( λ k − λ m )
这说明 v 1 , … , v m − 1 v_1,\dots,v_{m-1} v 1 , … , v m − 1 m − 1 m-1 m − 1 m m m
矛盾,故结论成立。■ \blacksquare ■
因为要制造更小的 反例。这是「极小反例法」:从所有反例里挑最小的一个,然后把它压得更小,矛盾。( T − λ m I ) v k = ( λ k − λ m ) v k (T-\lambda_mI)v_k=(\lambda_k-\lambda_m)v_k ( T − λ m I ) v k = ( λ k − λ m ) v k T − λ m I T-\lambda_mI T − λ m I v k v_k v k v m v_m v m 0 0 0
3.7 推论:特征值个数不超过维数 #
定理 :设 V V V V V V dim V \dim V dim V
证明只需两行:设 λ 1 , … , λ m \lambda_1,\dots,\lambda_m λ 1 , … , λ m v 1 , … , v m v_1,\dots,v_m v 1 , … , v m m m m m m m m ≤ dim V m\le\dim V m ≤ dim V
■ \blacksquare ■
于是:R 2 \mathbb{R}^2 R 2 2 2 2 C 5 \mathbb{C}^5 C 5 5 5 5 上界是维数,不是元素个数。
3.8 上三角矩阵 ⟺ 一条不变子空间链 #
这一节把「矩阵好看」与「子空间不变」正式焊在一起。
定理 :设 T ∈ L ( V ) T\in\mathcal{L}(V) T ∈ L ( V ) v 1 , … , v n v_1,\dots,v_n v 1 , … , v n V V V
(a) T T T k = 1 , … , n k=1,\dots,n k = 1 , … , n span ( v 1 , … , v k ) \operatorname{span}(v_1,\dots,v_k) span ( v 1 , … , v k ) T T T k = 1 , … , n k=1,\dots,n k = 1 , … , n T v k ∈ span ( v 1 , … , v k ) Tv_k\in\operatorname{span}(v_1,\dots,v_k) T v k ∈ span ( v 1 , … , v k )
证明(循环证 (a)⇒ \Rightarrow ⇒ ⇒ \Rightarrow ⇒ ⇒ \Rightarrow ⇒
先看清 (a) 到底说了什么。 M ( T ) M(T) M ( T ) k k k T v k Tv_k T v k 0 0 0 k k k k + 1 , k + 2 , … , n k+1,k+2,\dots,n k + 1 , k + 2 , … , n 0 0 0
T v k ∈ span ( v 1 , … , v k ) . Tv_k\in\operatorname{span}(v_1,\dots,v_k). T v k ∈ span ( v 1 , … , v k ) .
这一句就是 (c)。 所以 (a) 与 (c) 其实是同一句话的矩阵版和向量版。
(a)⇒ \Rightarrow ⇒ k k k j ≤ k j\le k j ≤ k T v j ∈ span ( v 1 , … , v j ) ⊆ span ( v 1 , … , v k ) Tv_j\in\operatorname{span}(v_1,\dots,v_j)\subseteq\operatorname{span}(v_1,\dots,v_k) T v j ∈ span ( v 1 , … , v j ) ⊆ span ( v 1 , … , v k ) j ≤ k j\le k j ≤ k span ( v 1 , … , v k ) \operatorname{span}(v_1,\dots,v_k) span ( v 1 , … , v k ) v 1 , … , v k v_1,\dots,v_k v 1 , … , v k T T T T v j Tv_j T v j T T T
(b)⇒ \Rightarrow ⇒ k k k span ( v 1 , … , v k ) \operatorname{span}(v_1,\dots,v_k) span ( v 1 , … , v k ) v k v_k v k T v k Tv_k T v k
(c)⇒ \Rightarrow ⇒ T v k Tv_k T v k v 1 , … , v k v_1,\dots,v_k v 1 , … , v k T v k Tv_k T v k v k v_k v k 0 0 0 M ( T ) M(T) M ( T ) k k k k k k 0 0 0 k k k M ( T ) M(T) M ( T ) ■ \blacksquare ■
这条定理最有用的读法 :
span ( v 1 ) ⊂ span ( v 1 , v 2 ) ⊂ ⋯ ⊂ V \operatorname{span}(v_1)\subset\operatorname{span}(v_1,v_2)\subset\cdots\subset V span ( v 1 ) ⊂ span ( v 1 , v 2 ) ⊂ ⋯ ⊂ V
一串每一个都不变 、且每步维数恰好加 1 1 1
由 (c) 取 k = 1 k=1 k = 1 T v 1 ∈ span ( v 1 ) Tv_1\in\operatorname{span}(v_1) T v 1 ∈ span ( v 1 ) T v 1 = λ 1 v 1 Tv_1=\lambda_1v_1 T v 1 = λ 1 v 1 第一个基向量一定是特征向量 ,而 λ 1 \lambda_1 λ 1 M ( T ) M(T) M ( T ) ( 1 , 1 ) (1,1) ( 1 , 1 ) T T T T T T 恰好 是该矩阵对角线上的各元素。只有 v 1 v_1 v 1 。v 2 , … , v n v_2,\dots,v_n v 2 , … , v n v k v_k v k M ( T ) M(T) M ( T ) k k k k k k 0 0 0
一个具体例子。 T ( x , y , z ) = ( 2 x + y , 5 y + 3 z , 8 z ) T(x,y,z)=(2x+y,\ 5y+3z,\ 8z) T ( x , y , z ) = ( 2 x + y , 5 y + 3 z , 8 z )
M ( T ) = ( 2 1 0 0 5 3 0 0 8 ) . M(T)=\begin{pmatrix}2&1&0\\ 0&5&3\\ 0&0&8\end{pmatrix}. M ( T ) = 2 0 0 1 5 0 0 3 8 .
上三角,对角线是 2 , 5 , 8 2,5,8 2 , 5 , 8 T T T 2 , 5 , 8 2,5,8 2 , 5 , 8 看一眼就报出来,不用解任何方程 。这就是「选对基」的回报。
3.9 多项式算子的零空间与值域也不变 #
设 p p p T T T p ( T ) p(T) p ( T ) p p p z z z T T T a 0 a_0 a 0 a 0 I a_0I a 0 I
定理 :null p ( T ) \operatorname{null}p(T) null p ( T ) range p ( T ) \operatorname{range}p(T) range p ( T ) T T T
证明。 关键在于 T T T p ( T ) p(T) p ( T ) 可交换 :T p ( T ) = p ( T ) T T\,p(T)=p(T)\,T T p ( T ) = p ( T ) T T T T T k T^k T k p ( T ) p(T) p ( T ) T T T
设 u ∈ null p ( T ) u\in\operatorname{null}p(T) u ∈ null p ( T ) p ( T ) u = 0 p(T)u=0 p ( T ) u = 0
p ( T ) ( T u ) = ( p ( T ) T ) u = ( T p ( T ) ) u = T ( p ( T ) u ) = T 0 = 0 , p(T)(Tu)=\bigl(p(T)T\bigr)u=\bigl(Tp(T)\bigr)u=T\bigl(p(T)u\bigr)=T0=0, p ( T ) ( T u ) = ( p ( T ) T ) u = ( T p ( T ) ) u = T ( p ( T ) u ) = T 0 = 0 ,
所以 T u ∈ null p ( T ) Tu\in\operatorname{null}p(T) T u ∈ null p ( T )
设 u ∈ range p ( T ) u\in\operatorname{range}p(T) u ∈ range p ( T ) u = p ( T ) v u=p(T)v u = p ( T ) v
T u = T ( p ( T ) v ) = p ( T ) ( T v ) ∈ range p ( T ) . Tu=T\bigl(p(T)v\bigr)=p(T)(Tv)\in\operatorname{range}p(T). T u = T ( p ( T ) v ) = p ( T ) ( T v ) ∈ range p ( T ) .
■ \blacksquare ■
把 p ( z ) = z p(z)=z p ( z ) = z p ( T ) = T p(T)=T p ( T ) = T null T \operatorname{null}T null T range T \operatorname{range}T range T p ( z ) = z − λ p(z)=z-\lambda p ( z ) = z − λ null ( T − λ I ) \operatorname{null}(T-\lambda I) null ( T − λ I ) 而它就是「对应 λ \lambda λ 0 0 0 。
四、几何直观 / 记忆钩子 #
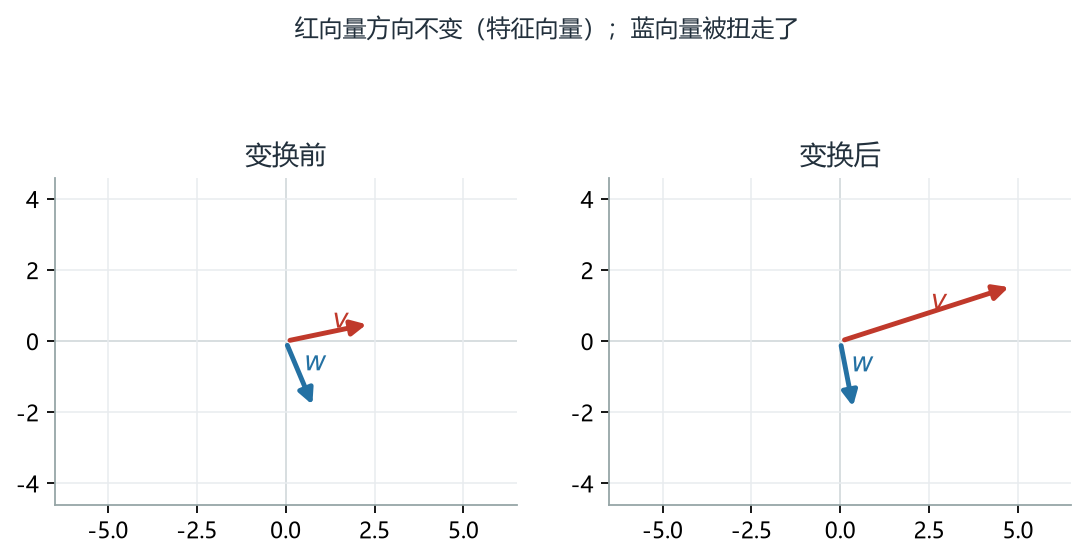
左图是变换前,右图是变换后:红色向量前后仍在同一条直线上(只是被拉长),蓝色向量则偏离了原来的方向
看图说话:
红色向量 变换后与原来共线 ,只是长度变了。这就是特征向量:T v = λ v Tv=\lambda v T v = λ v ∣ λ ∣ |\lambda| ∣ λ ∣ T T T 一维不变子空间 。蓝色向量 变换后偏离 了原来的方向。它张成的直线没有被 T T T T w Tw T w span ( w ) \operatorname{span}(w) span ( w )
「特征向量方向不变」里的「不变」是共线 ,不是不动 。λ = 2 \lambda=2 λ = 2 λ = 1 2 \lambda=\frac12 λ = 2 1 λ = − 1 \lambda=-1 λ = − 1 反向 ,λ = 0 \lambda=0 λ = 0 压成零 (此时向量虽被压掉,但那条直线仍在 T T T 0 0 0 λ = 1 \lambda=1 λ = 1
三个记忆钩子:
钩子一:把「不变」读成「关得住」。 T T T U U U T u ∈ U Tu\in U T u ∈ U 还在屋子里 ,没漏出去。漏出去了,T ∣ U T|_U T ∣ U
钩子二:λ \lambda λ
λ \lambda λ 几何动作
直觉
λ > 1 \lambda>1 λ > 1 沿该方向拉长
方向被强化
0 < λ < 1 0<\lambda<1 0 < λ < 1 沿该方向压缩
方向被削弱
λ = 0 \lambda=0 λ = 0 整条线压成原点
方向被抹掉(v ∈ null T v\in\operatorname{null}T v ∈ null T
λ < 0 \lambda<0 λ < 0 反向拉伸
方向被翻转
钩子三:上三角 = 一层层关得住的套娃。 v 1 v_1 v 1 v 2 v_2 v 2 v 1 v_1 v 1 … \dots … n n n
五、常见误区 #
T 0 = λ 0 T0=\lambda 0 T 0 = λ 0 λ \lambda λ 任何 λ \lambda λ 定义里的 v ≠ 0 v\neq 0 v = 0 v ≠ 0 v\neq 0 v = 0
误区 2:把 T ( U ) ⊆ U T(U)\subseteq U T ( U ) ⊆ U T ( U ) = U T(U)=U T ( U ) = U 定义只要求包含 ,不要求相等 。T ( w , z ) = ( 0 , w ) T(w,z)=(0,w) T ( w , z ) = ( 0 , w ) U = span ( 1 , 0 ) U=\operatorname{span}(1,0) U = span ( 1 , 0 ) T ( 1 , 0 ) = ( 0 , 0 ) ∈ U T(1,0)=(0,0)\in U T ( 1 , 0 ) = ( 0 , 0 ) ∈ U U U U T ( U ) = { 0 } ≠ U T(U)=\{0\}\neq U T ( U ) = { 0 } = U T ∣ U T|_U T ∣ U U U U U U U U U U T T T U U U T T T U U U
错。R 2 \mathbb{R}^2 R 2 T ( w , z ) = ( − z , w ) T(w,z)=(-z,w) T ( w , z ) = ( − z , w ) P ( C ) \mathcal{P}(\mathbb{C}) P ( C ) ( T p ) ( z ) = z p ( z ) (Tp)(z)=zp(z) ( T p ) ( z ) = z p ( z ) z p zp z p p p p 1 1 1 p p p 「有限维」与「复数域」这两个条件缺一个,存在性就没有保证。
误区 4:以为不变子空间只有 { 0 } \{0\} { 0 } V V V 这两个叫平凡不变子空间,但中间那一堆通常是存在的。T ( x , y , z ) = ( 2 x + y , 5 y + 3 z , 8 z ) T(x,y,z)=(2x+y,5y+3z,8z) T ( x , y , z ) = ( 2 x + y , 5 y + 3 z , 8 z ) span ( e 1 ) \operatorname{span}(e_1) span ( e 1 ) span ( e 1 , e 2 ) \operatorname{span}(e_1,e_2) span ( e 1 , e 2 ) 构造性地找出它们并不容易 ——一般要靠找特征向量,而特征向量又要解方程。
这两件事毫无关系,只是结果都长得像三角形。
行化简 是对同一个矩阵 做初等行变换,求的是方程组解集、秩——那是 09 讲的内容。上三角化 是换一组基 ,同一个算子在不同基下矩阵不同,求的是「有没有一组基让矩阵变简单」。
一个非零向量只能 对应一个特征值。若 T v = λ v Tv=\lambda v T v = λ v T v = μ v Tv=\mu v T v = μv ( λ − μ ) v = 0 (\lambda-\mu)v=0 ( λ − μ ) v = 0 v ≠ 0 v\neq 0 v = 0 λ = μ \lambda=\mu λ = μ λ 1 \lambda_1 λ 1 λ 2 \lambda_2 λ 2 λ 1 ≠ λ 2 \lambda_1\neq\lambda_2 λ 1 = λ 2 只在零向量处相交 。
六、拓展(可选,可跳过) #
6.1 不变子空间的用处:商算子 #
有了不变子空间,就能在商空间上继承算子。设 U U U T T T
( T / U ) ( v + U ) = T v + U . (T/U)(v+U)=Tv+U . ( T / U ) ( v + U ) = T v + U .
U U U 必须的 :否则「v + U v+U v + U T v + U Tv+U T v + U
于是「T T T U U U T T T V / U V/U V / U 算子可以顺着不变子空间往下传 ,这是后面很多结构定理的起点。
6.2 平凡的不变子空间什么时候一定存在 #
如果 dim V = n ≥ 1 \dim V=n\ge 1 dim V = n ≥ 1 F = C \mathbb{F}=\mathbb{C} F = C T T T F = R \mathbb{F}=\mathbb{R} F = R n n n
但 R 2 \mathbb{R}^2 R 2 实数域 + 偶数维 时可以一个都没有。
6.3 一条更细的观察 #
「U U U T T T U U U 任意多项式 p ( T ) p(T) p ( T ) p ( T ) p(T) p ( T ) T T T T k u T^k u T k u U U U
这条常被用来做一件事:若 U U U U U U T − λ I T-\lambda I T − λ I (取 p ( z ) = z − λ p(z)=z-\lambda p ( z ) = z − λ ( T − λ I ) ∣ U (T-\lambda I)|_U ( T − λ I ) ∣ U U U U
七、自测 #
1. 设 T ( x , y ) = ( 3 x + y , 2 y ) T(x,y)=(3x+y,\ 2y) T ( x , y ) = ( 3 x + y , 2 y ) x x x T T T T T T
2. 设 T ( w , z ) = ( z , w ) T(w,z)=(z,w) T ( w , z ) = ( z , w ) T T T
3. 设 U U U T T T U U U T 2 T^2 T 2 U U U p ( T ) p(T) p ( T ) p p p
4. 设 T ( z 1 , z 2 , z 3 ) = ( 2 z 2 , 0 , 5 z 3 ) T(z_1,z_2,z_3)=(2z_2,\ 0,\ 5z_3) T ( z 1 , z 2 , z 3 ) = ( 2 z 2 , 0 , 5 z 3 ) T T T 2 2 2
5. 设 U , W U,W U , W T T T U ∩ W U\cap W U ∩ W U + W U+W U + W T T T
答案(点开) 1. x x x ( x , 0 ) (x,0) ( x , 0 ) T ( x , 0 ) = ( 3 x , 0 ) T(x,0)=(3x,0) T ( x , 0 ) = ( 3 x , 0 ) x x x 不变 。T ( x , 0 ) = 3 ( x , 0 ) T(x,0)=3(x,0) T ( x , 0 ) = 3 ( x , 0 ) e 1 e_1 e 1 3 3 3 T ( x , y ) = λ ( x , y ) T(x,y)=\lambda(x,y) T ( x , y ) = λ ( x , y ) 3 x + y = λ x 3x+y=\lambda x 3 x + y = λ x 2 y = λ y 2y=\lambda y 2 y = λ y y = 0 y=0 y = 0 λ = 3 \lambda=3 λ = 3 λ = 2 \lambda=2 λ = 2 x + y = 0 x+y=0 x + y = 0 ( 1 , − 1 ) (1,-1) ( 1 , − 1 ) 3 3 3 2 2 2 3 3 3 span ( 1 , 0 ) \operatorname{span}(1,0) span ( 1 , 0 ) 2 2 2 span ( 1 , − 1 ) \operatorname{span}(1,-1) span ( 1 , − 1 ) ( 3 1 0 2 ) \begin{pmatrix}3&1\\0&2\end{pmatrix} ( 3 0 1 2 ) 3 , 2 3,2 3 , 2
2. 解 T ( w , z ) = λ ( w , z ) T(w,z)=\lambda(w,z) T ( w , z ) = λ ( w , z ) z = λ w z=\lambda w z = λ w w = λ z w=\lambda z w = λ z w = λ 2 w w=\lambda^2w w = λ 2 w ( w , z ) ≠ 0 (w,z)\neq 0 ( w , z ) = 0 w ≠ 0 w\neq 0 w = 0 w = 0 w=0 w = 0 z = 0 z=0 z = 0 λ 2 = 1 \lambda^2=1 λ 2 = 1 λ = ± 1 \lambda=\pm 1 λ = ± 1 λ = 1 \lambda=1 λ = 1 z = w z=w z = w ( w , w ) (w,w) ( w , w ) w ≠ 0 w\neq 0 w = 0 span ( 1 , 1 ) \operatorname{span}(1,1) span ( 1 , 1 ) λ = − 1 \lambda=-1 λ = − 1 z = − w z=-w z = − w ( w , − w ) (w,-w) ( w , − w ) w ≠ 0 w\neq 0 w = 0 span ( 1 , − 1 ) \operatorname{span}(1,-1) span ( 1 , − 1 ) y = x y=x y = x y = − x y=-x y = − x
3. 设 u ∈ U u\in U u ∈ U U U U T u ∈ U Tu\in U T u ∈ U T u Tu T u T ( T u ) = T 2 u ∈ U T(Tu)=T^2u\in U T ( T u ) = T 2 u ∈ U U U U T 2 T^2 T 2 p ( T ) = a 0 I + a 1 T + ⋯ + a m T m p(T)=a_0I+a_1T+\cdots+a_mT^m p ( T ) = a 0 I + a 1 T + ⋯ + a m T m T k u ∈ U T^ku\in U T k u ∈ U k ≥ 0 k\ge 0 k ≥ 0 k = 0 k=0 k = 0 I u = u ∈ U Iu=u\in U I u = u ∈ U U U U a 0 u + a 1 T u + ⋯ + a m T m u ∈ U a_0u+a_1Tu+\cdots+a_mT^mu\in U a 0 u + a 1 T u + ⋯ + a m T m u ∈ U p ( T ) p(T) p ( T ) U U U U U U
4. 解 T ( z 1 , z 2 , z 3 ) = λ ( z 1 , z 2 , z 3 ) T(z_1,z_2,z_3)=\lambda(z_1,z_2,z_3) T ( z 1 , z 2 , z 3 ) = λ ( z 1 , z 2 , z 3 ) 2 z 2 = λ z 1 2z_2=\lambda z_1 2 z 2 = λ z 1 0 = λ z 2 0=\lambda z_2 0 = λ z 2 5 z 3 = λ z 3 5z_3=\lambda z_3 5 z 3 = λ z 3
λ = 0 \lambda=0 λ = 0 z 2 = 0 z_2=0 z 2 = 0 z 3 = 0 z_3=0 z 3 = 0 ( z 1 , 0 , 0 ) (z_1,0,0) ( z 1 , 0 , 0 ) z 1 ≠ 0 z_1\neq 0 z 1 = 0 λ = 5 \lambda=5 λ = 5 z 2 = 0 z_2=0 z 2 = 0 0 = 5 z 1 0=5z_1 0 = 5 z 1 z 1 = 0 z_1=0 z 1 = 0 ( 0 , 0 , z 3 ) (0,0,z_3) ( 0 , 0 , z 3 ) z 3 ≠ 0 z_3\neq 0 z 3 = 0 λ = 2 \lambda=2 λ = 2 z 2 = 0 z_2=0 z 2 = 0 0 = 2 z 1 0=2z_1 0 = 2 z 1 z 1 = 0 z_1=0 z 1 = 0 5 z 3 = 2 z 3 5z_3=2z_3 5 z 3 = 2 z 3 z 3 = 0 z_3=0 z 3 = 0 不行 。0 0 0 5 5 5 2 2 2 矩阵里出现的数字不必都是特征值 ——2 2 2 非对角 元素,它只描述「z 2 z_2 z 2 T T T
( 0 2 0 0 0 0 0 0 5 ) , \begin{pmatrix}0&2&0\\ 0&0&0\\ 0&0&5\end{pmatrix}, 0 0 0 2 0 0 0 0 5 ,
上三角,对角线是 0 , 0 , 5 0,0,5 0 , 0 , 5 对角线 才给出全部特征值,答案正是 { 0 , 5 } \{0,5\} { 0 , 5 } 0 0 0
5. U ∩ W U\cap W U ∩ W u ∈ U ∩ W u\in U\cap W u ∈ U ∩ W u ∈ U u\in U u ∈ U u ∈ W u\in W u ∈ W T u ∈ U Tu\in U T u ∈ U T u ∈ W Tu\in W T u ∈ W T u ∈ U ∩ W Tu\in U\cap W T u ∈ U ∩ W U + W U+W U + W u + w u+w u + w u ∈ U , w ∈ W u\in U,w\in W u ∈ U , w ∈ W T ( u + w ) = T u + T w ∈ U + W T(u+w)=Tu+Tw\in U+W T ( u + w ) = T u + T w ∈ U + W T u ∈ U Tu\in U T u ∈ U T w ∈ W Tw\in W T w ∈ W U ∪ W U\cup W U ∪ W 不一定 不变——它不是子空间,且 T u + T w Tu+Tw T u + T w
八、复习卡 #
项
内容
不变子空间 U U U ∀ u ∈ U : T u ∈ U \forall u\in U:\ Tu\in U ∀ u ∈ U : T u ∈ U T ( U ) ⊆ U T(U)\subseteq U T ( U ) ⊆ U
关系是 ⊆ \subseteq ⊆ 允许 T ( U ) T(U) T ( U ) U U U T ∣ U T|_U T ∣ U
四个白送的例子 { 0 } \{0\} { 0 } V V V null T \operatorname{null}T null T range T \operatorname{range}T range T
一维情形 span ( v ) \operatorname{span}(v) span ( v ) ⟺ \iff ⟺ λ \lambda λ T v = λ v Tv=\lambda v T v = λ v
核心等价 V V V ⟺ \iff ⟺ T T T
特征值 λ \lambda λ v ≠ 0 v\neq 0 v = 0 T v = λ v Tv=\lambda v T v = λ v
特征向量 该 v v v v ≠ 0 v\neq 0 v = 0 λ \lambda λ
特征空间 对应 λ \lambda λ 0 0 0 null ( T − λ I ) \operatorname{null}(T-\lambda I) null ( T − λ I )
四个等价 λ \lambda λ ⟺ \iff ⟺ T − λ I T-\lambda I T − λ I ⟺ \iff ⟺ ⟺ \iff ⟺ 需有限维 )
互异特征值 对应的特征向量组必线性无关(极小反例法证)
个数上界 互异特征值个数 ≤ dim V \le\dim V ≤ dim V
上三角等价 M ( T ) M(T) M ( T ) ⟺ \iff ⟺ span ( v 1 , … , v k ) \operatorname{span}(v_1,\dots,v_k) span ( v 1 , … , v k ) ⟺ \iff ⟺ T v k ∈ span ( v 1 , … , v k ) Tv_k\in\operatorname{span}(v_1,\dots,v_k) T v k ∈ span ( v 1 , … , v k )
对角线 有上三角矩阵时,对角线元素恰为全部特征值;只有 v 1 v_1 v 1
多项式 null p ( T ) \operatorname{null}p(T) null p ( T ) range p ( T ) \operatorname{range}p(T) range p ( T ) T T T T T T p ( T ) p(T) p ( T )
数域要紧 旋转 90 ∘ 90^\circ 9 0 ∘ R 2 \mathbb{R}^2 R 2 C 2 \mathbb{C}^2 C 2 ± i \pm i ± i
易混 上三角化(换基)≠ \neq =
九、出处与延伸(可选,不影响阅读) #
主要出处 :Sheldon Axler《线性代数应该这样学》第 4 版,第 5 章 5A 节「不变子空间·特征值」(PDF p126–131,印刷 p113–118)。本讲的定义顺序为:算子(5.1)→ 不变子空间(5.2)→ 微分算子例(5.3)→ 四个不变子空间(5.4)→ 一维情形 → 特征值(5.5)→ 特征值例(5.6)→ 等价条件(5.7)→ 特征向量(5.8)→ 旋转例(5.9)→ 无关性(5.11)→ 个数上界(5.12),与原文一致。多项式算子部分 :p ( T ) p(T) p ( T ) p ( T ) p(T) p ( T ) 上三角矩阵 :见 5C 节(PDF p142–147,印刷 p129–134)。5.39(三个等价条件)、5.40(( T − λ 1 I ) ⋯ ( T − λ n I ) = 0 (T-\lambda_1I)\cdots(T-\lambda_nI)=0 ( T − λ 1 I ) ⋯ ( T − λ n I ) = 0 ⟺ \iff ⟺ 术语别名 :不变子空间 = invariant subspace;特征值 = 本征值 = eigenvalue;特征向量 = 本征向量 = eigenvector;「算子的矩阵」记作 M ( T ) M(T) M ( T ) T T T 想深挖时可查 :
「U U U ⇒ \Rightarrow ⇒ T / U T/U T / U
特征值存在性(复空间、有限维必存在)依赖代数基本定理,即「每个复系数多项式有根」;
想找更多反例,可自行构造 R 2 \mathbb{R}^2 R 2 ( cos θ − sin θ sin θ cos θ ) \begin{pmatrix}\cos\theta&-\sin\theta\\ \sin\theta&\cos\theta\end{pmatrix} ( cos θ sin θ − sin θ cos θ ) θ ∉ { 0 , π } \theta\notin\{0,\pi\} θ ∈ / { 0 , π }